生成AIの社内ルールに書くことは、6項目に絞れます。使ってよいサービス、入力してよい情報、データの扱いの確認、出力の確認手順、権利侵害のチェック、相談窓口と記録です。この6つは、公的機関が無償で公開している資料だけで組み立てられます。
出発点として、総務省の令和8年版情報通信白書(2026年7月24日公表)にある対比を見てください。2025年度の調査で、就業者に自社の状況を尋ねたところ、「全社的な指針やガイドラインを整備している」と答えた割合は41.1%でした。一方で「生成AIへの入力データを学習データとして利用できない仕組みを導入している」と答えた割合は19.9%です。
白書はこの調査を「2025年度企業向け調査」と呼びますが、答えているのは企業ではなく、そこに勤める就業者です。この記事で引く白書の数字は、すべてこの読み方をします。
41.1%と19.9%は別々の設問への回答なので、19.9%が41.1%の内数とは限りません。それでも、全体の水準として倍以上の開きがあります。文書を書くだけでは足りません。
この記事で扱うのは次の6つです。
- 公的ガイドラインと社内ルールの役割分担
- 2026年9月時点で参照すべき7つの文書と、読む順
- 生成AIガイドラインに書く6項目
- 無償のひな形を自社版に直す段取り
- 2023〜2024年のルールには無い、いま足すべき3項目
- 自社名を入れれば使えるA4一枚の文例
生成AIガイドラインで決めること
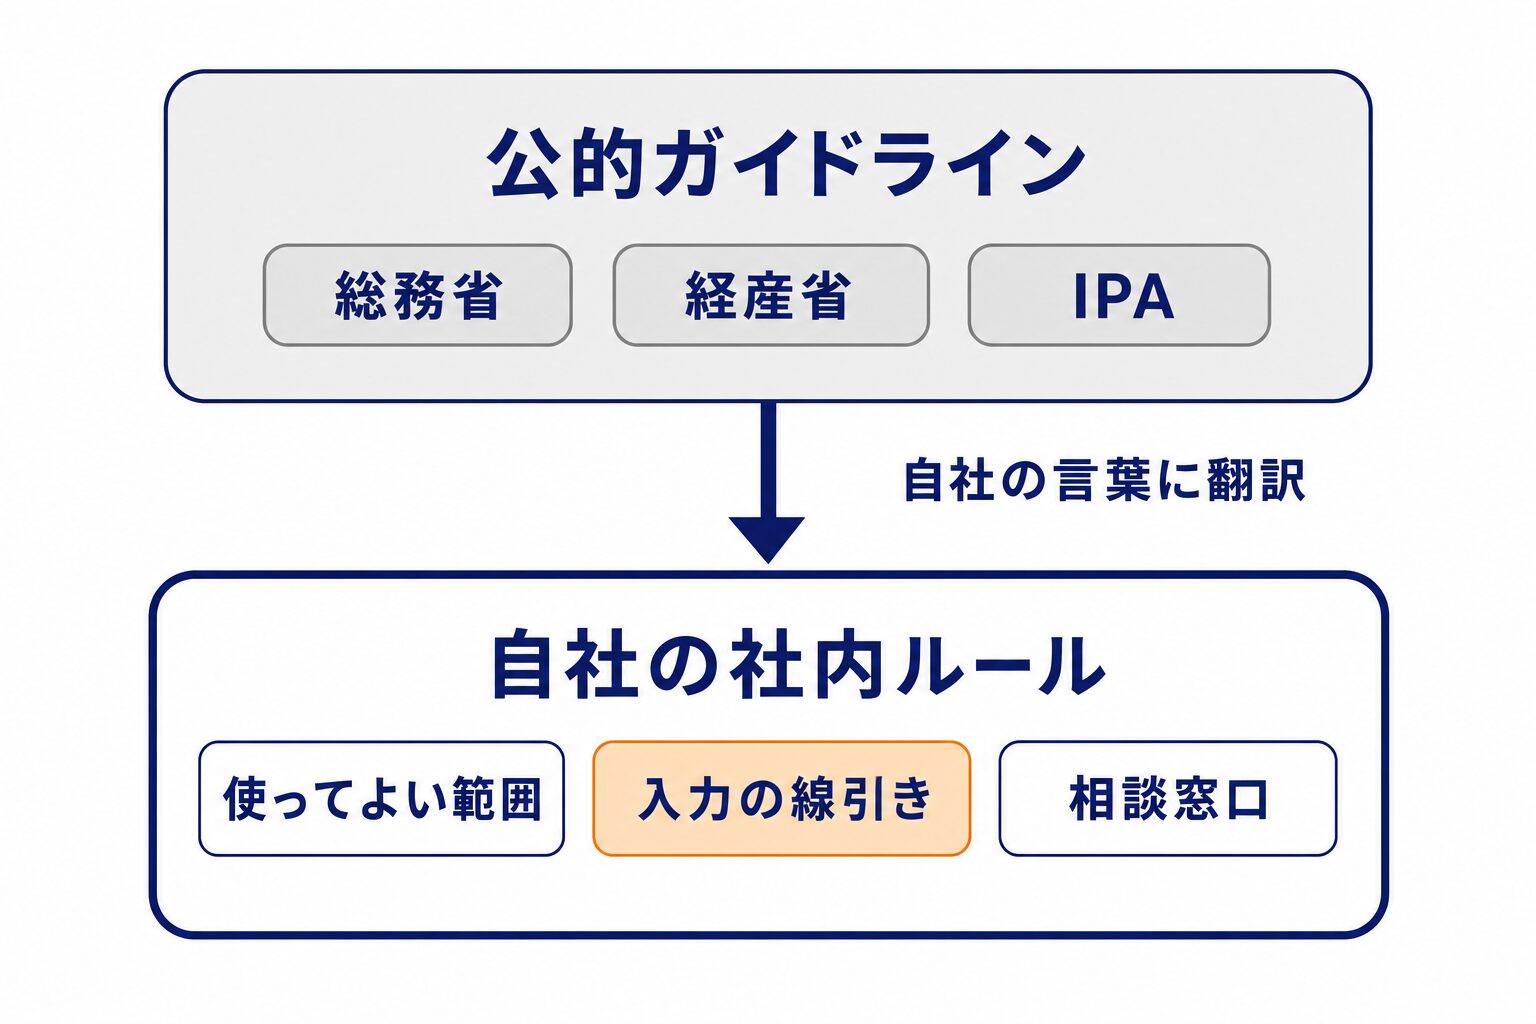
社内ルールで決めるのは「自社はどう判断するか」です。何が危ないかは公的資料にすでに書かれています。書かれていないのは、自社が使ってよいサービス名、入力してよい情報の範囲、迷ったときの相談先です。
公的ガイドラインと社内ルールの役割分担
公的ガイドラインは、業種を問わず通用する考え方を示します。社内ルールは、その考え方を自社の固有名詞に落とします。両方を1つの文書に混ぜると、読む側が「で、うちでは何をしていいのか」を取り出せなくなります。
たとえばAI事業者ガイドラインは、AIに関わる事業者を「AI開発者」「AI提供者」「AI利用者」の3つに分けています。AI利用者は「事業活動において、AIシステム又はAIサービスを利用する事業者」と定義されています。
生成AIを買って使うだけの会社は、この定義でいうAI利用者です。読むのは、全主体に共通する第2部と、利用者向けの第5部で足ります。第3部と第4部は開発者と提供者に向けた章なので、自社には当てはまりません。
ここを取り違えると、読むべき分量を大きく見誤ります。
社内の利用実態の確かめ方
ルールを書く前に、社内で誰がどれだけ使っているかを数えてください。使用禁止が前提なのか、すでに全員が使っているのかで、書く文章がまるで変わるからです。
生成AIの研修と導入支援を仕事にしていて、ある業界団体系の組織で職員向けの講座を担当したときのことです。冒頭に利用頻度を挙手で尋ねました。「使ったことがない」「月1回以上」「週1回以上」「毎日」の4択です。結果は全員が使用経験ありで、週1回以上から毎日までに分布していました。
一方で、組織として生成AIツールの利用が公式に決まっている組織は限られていました。個人の利用だけが先に広がり、会社側のルールが追いついていない状態です。同じ挙手を別の回でも取っていますが、「毎日使う」と答える層は増えてきている実感があります。
この状況で「原則禁止」とだけ書いた文書を配ると、実態が水面下に潜ります。白書の集計は、活用方針を「わからない」と答えた7.4%を除いたものです。その集計で就業者に自社の状況を尋ねたところ、何らかの業務で生成AIを利用していると答えた割合は86.4%でした。使わせるかどうかを決める段階は終わり、どう使わせるかを書く段階に来ています。
まだ社内で試していない段階であれば、ChatGPTの始め方から先に確かめてください。実際の画面を触らずに書いたルールは、現場の操作と噛み合いません。
規模に応じた水準という考え方
中小企業が大企業と同じ体制を作る必要はありません。これは根性論ではなく、政府の指針に書かれています。
AI法第13条に基づく適正性確保に関する指針が、令和7年12月19日に人工知能戦略本部で決定されました。この指針は、取り組むべき事項についてこう書いています(引用は原文の表記のまま)。「各主体の規模や立場、AIがもたらすリスクに応じて、その時点で適用し得る技術や知見を踏まえて適切な水準で対応することが求められる」。
同じ指針が挙げる基本方針は4つです。リスクベースでのアプローチ、ステークホルダーの積極的な関与、一気通貫でのAIガバナンスの構築、アジャイルな対応。平たく言えば、リスクに応じて対策を決める、関係者の声を聞く、導入前から運用後まで一続きで管理する、決めた内容を随時見直す、です。AIガバナンスも、社内でAIを安全に使うための管理の仕組みと読み替えれば足ります。
中小企業に効くのは1つ目です。リスクの小さい使い方に、重い手続きを付ける必要はありません。
白書の数字も、この読み方を裏づけます。「全社的な指針やガイドラインを整備している」の割合を企業規模別に見ると、大企業で44.9%、中小企業で29.1%でした。いずれも、そこに勤める就業者が自社について答えた割合です。
差は15ポイントほどです。一方で「特に実施している施策はない・把握していない」は、大企業13.8%に対し中小企業24.1%でした。整備の水準そのものより、何も決めていない状態のほうが問題だと読めます。
日本の公的ルールの現在地(2026年9月時点)
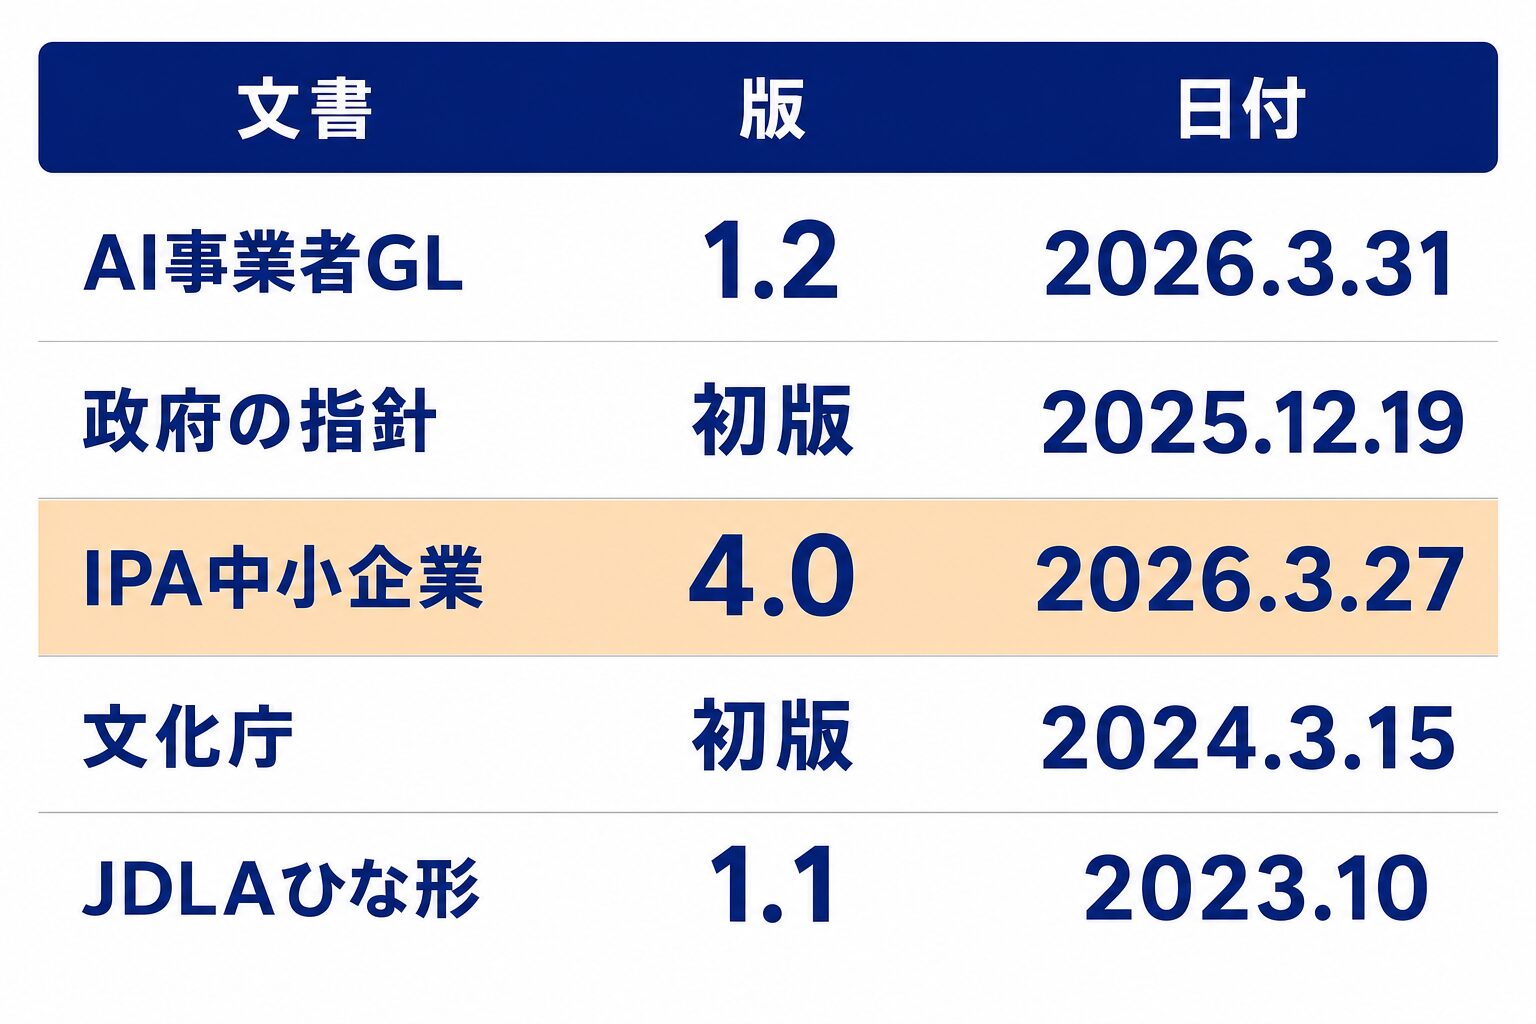
参照すべき文書は7つで、版と日付を押さえておけば足ります。検索で上位に出る解説記事は古い版を前提にしていることがあるため、原文の表紙で版数を確かめてください。
参照する7つの文書と読む順
| 文書 | 発行 | 現在の版・日付 |
|---|---|---|
| AI事業者ガイドライン | 総務省・経済産業省 | 第1.2版 令和8年3月31日 |
| 適正性確保に関する指針 | 人工知能戦略本部 | 令和7年12月19日決定 |
| AI法 | 内閣府 | 令和7年法律第53号(令和7年9月1日全面施行) |
| 中小企業の情報セキュリティ対策ガイドライン | IPA・経済産業省 | 第4.0版 2026年3月27日 |
| 生成AIサービスの利用に関する注意喚起等 | 個人情報保護委員会 | 令和5年6月2日 |
| AIと著作権に関する考え方について | 文化審議会著作権分科会 | 令和6年3月15日 |
| 生成AIの利用ガイドライン | 日本ディープラーニング協会(JDLA) | 第1.1版 2023年10月公開 |
7つを全部読む必要はありません。まず読むのは2本です。1本は、国の独立行政法人である情報処理推進機構(IPA)が出した第4.0版のP.47のコラム。もう1本は、民間の業界団体である日本ディープラーニング協会(JDLA)のひな形です。残りは、書いた内容の根拠を示す必要が出たときに当たれば足ります。
AI事業者ガイドラインは第1.2版が最新です。解説記事の多くは第1.1版を前提にしているので、原文と突き合わせてください。
文化庁の「AIと著作権に関する考え方について」は、令和6年3月15日のものが現在も最新です。ただし、文書自身が次のように明記しています。「法的な拘束力を有するものではなく、また現時点で存在する特定の生成AIやこれに関する技術について、確定的な法的評価を行うものではない」。
AI法と既存法の関係
AI法(人工知能関連技術の研究開発及び活用の推進に関する法律)は、推進のための法律で罰則を持ちません。全条文を確認しても、罰・懲役・罰金・過料のいずれも出てきません。企業にかかるのは第7条の責務規定だけです。
生成AIの使い方で実際に問われるのは、個人情報保護法、著作権法、不正競争防止法です。罰則がないことと、何もしなくてよいことは別です。
なお本記事が扱うのは日本国内の法令とガイドラインです。EU域内に製品やサービスを提供している場合は、EUのAI規則(EU AI Act)が別途かかります。
個人情報と機密情報の扱い
個人情報保護委員会は令和5年6月2日の注意喚起で、次のように書いています。「個人情報取扱事業者が、あらかじめ本人の同意を得ることなく生成AIサービスに個人データを含むプロンプトを入力し、当該個人データが当該プロンプトに対する応答結果の出力以外の目的で取り扱われる場合、当該個人情報取扱事業者は個人情報保護法の規定に違反することとなる可能性がある」。
だからこそ同じ文書は、生成AIサービスの提供事業者が「当該個人データを機械学習に利用しないこと等を十分に確認すること」と求めています。この一文が、社内ルールで「学習に使わせない設定」を求める根拠になります。3年以上前の文書ですが、撤回も更新もされていません。
個人データを入力する運用を考えるなら、論点はほかにもあります。提供事業者が外国にある場合の整理と、取得時に本人へ伝えた利用目的の範囲内かどうかです。いずれも個人情報保護委員会の資料に当たってください。
自社の機密情報も、入力すると扱いが変わることがあります。JDLAのひな形は、機密情報を入力する行為そのものが法令違反になるわけではないと整理したうえで、こう注意しています。「生成AIの処理内容や規約の内容によっては当該機密情報が法律上保護されなくなったり特許出願ができなくなったりしてしまうリスクがあります」。IPAが「クラウドAIに営業秘密は教えない」を見出しに置いているのも、同じ心配からだと読めます。
商品名やキャッチコピーを生成AIで考える場合は、著作権と商標の確認が別に必要です。手順はChatGPTでのネーミングと商標確認にまとめました。
背景として、個人情報保護法は令和8年7月17日に改正法が公布され、課徴金制度の新設が盛り込まれました。施行はこれからで、細部は確定していません。いま作るルールに直接書き込む必要はありませんが、個人データの扱いが軽くなる方向には進んでいません。
生成AIガイドラインに書く6項目
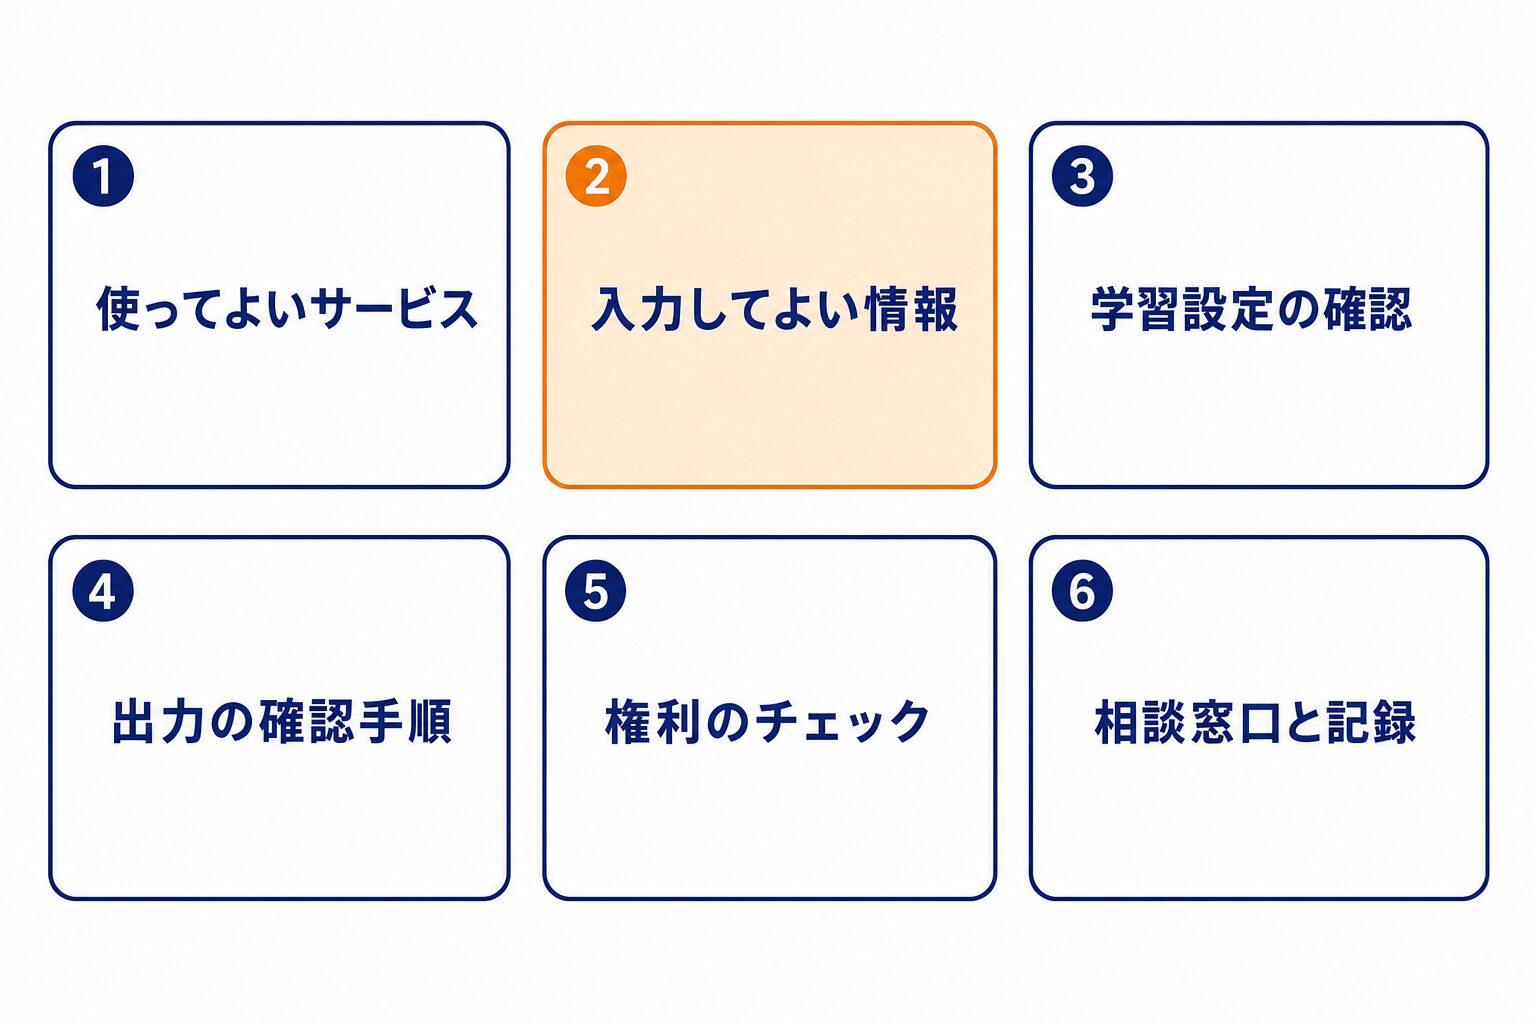
6項目は、使ってよいサービス、入力してよい情報、データの扱いの確認、出力の確認手順、権利のチェック、相談窓口と記録です。この並びは、IPAが中小企業向けに挙げた4点を骨にして、JDLAのひな形とAI事業者ガイドラインの利用者向け項目で肉づけしたものです。
中小企業の情報セキュリティ対策ガイドライン 第4.0版のP.47を開いてください。「生成AIの利用とサイバーセキュリティ ― 安全な活用のために」という1ページのコラムがあり、注意すべき点として4つが挙がっています(原文より引用)。
1. 生成AIの利用規約やプライバシーポリシーを事前に確認し、データの取り扱い方針を把握する
2. 機密性の高い情報や個人情報など、外部に漏れると問題になるデータはAIサービスに入力しない
3. 生成された成果物は必ず人間が確認し、正確性や法的リスクをチェックする
4. AIの出力内容をそのまま業務で利用するのではなく、補助的ツールとして活用する
ここに「使ってよいサービスを決める」と「相談窓口と記録を決める」を足すと6項目になります。前者はJDLAのひな形が第2章で、後者はAI事業者ガイドラインの別添が求めているものです。
使ってよいサービスの決め方
サービスは列挙してください。JDLAのひな形は、業務利用を許可する場合に「ホワイトリスト方式(利用してよいサービスを特定した上で列挙する方式)で指定すること」を勧めています。理由も明記されていて、生成AIはサービスの構造や処理内容によって法的リスクが異なるからです。
禁止リスト方式にすると、新しいサービスが出るたびに穴が開きます。リストに無いものは原則として使わない、使いたければ窓口に相談する、という形にしてください。
AI事業者ガイドラインの第5部にも、規約の遵守という項目があります。「AI提供者が定めたサービス規約を遵守する」と書かれていますが、個人が勝手に契約したサービスでは、会社として規約を確認しようがありません。
入力してよい情報の線引き
線引きは、禁止するものを並べるより、入れてよいものを挙げるほうが伝わります。
先ほどの職員向け講座では、学習目標の3つ目を「取り扱う情報の機密性を考慮して、入力してよい情報とダメな情報を区別できる」と置きました。そのうえで伝え方を変え、「入力してよいのは公開情報と架空データ」という許可する側を挙げる形にしました。
禁止列挙だと、リストに書いていない情報の扱いが宙に浮きます。許可リストなら、迷った時点で「窓口に聞く」に着地します。判断の重さを現場に預けずに済むのが利点です。
この講座では、上位の基準と自組織のルールの関係も伝えました。上位の基準が許している範囲であっても、自組織の取扱ルールに沿って機微な情報は入れないほうが安全だ、という案内をしました。上位の基準に合わせるだけでは、自社のルールにはなりません。
架空データで足りる業務は、思っているより多くあります。たとえばChatGPTでペルソナを作るような検討は、実在の顧客データを入れなくても成立します。
顧客情報を日常的に扱う部門は、工程ごとに線を引くと運用が楽になります。たとえばChatGPTを活用したインサイドセールスなら、どこまでを架空データで回せるかを先に決めておきます。
AI事業者ガイドラインの第5部にも、個人情報の不適切な入力への対策とセキュリティ対策の実施が挙がっています。後者には「AIシステム・サービスに機密情報等を不適切に入力することがないよう注意を払う」とあります。
プランで変わる「学習に使われるか」
同じサービス名でも、法人向けか個人向けかで学習の既定が変わります。ここを確認せずに「ChatGPTは学習に使われる」と書くと、自社の実態と合わないルールになります。
主要4サービスの公式ページを2026年9月14日に確認した結果が次の表です。
| サービス | 法人・商用プランの既定 | 個人向けプランの扱い |
|---|---|---|
| ChatGPT(OpenAI) | 既定で入力も出力も学習に使わない | 学習に使われることがある。設定でオフにできる |
| Claude(Anthropic) | 既定で入力も出力も学習に使わない | 本人が許可した場合などに使われる |
| Gemini(Google) | 顧客の許可や指示なく学習に使わない | 一部の会話が人によるレビュー対象になる |
| Microsoft 365 Copilot | 基盤モデルの学習に使わない | 本記事では確認できていない |
OpenAIのヘルプページは法人向けについて、ChatGPT Business、ChatGPT Enterprise、APIを含む製品では既定で学習に使わないと書いています(原文「By default, we do not train on any inputs or outputs from our products for business users」)。個人向けについては、ChatGPTやCodexの利用時に内容を学習に使うことがあるとしています。私用で使う社員には、設定画面のData Controlsを案内しておくと親切です。「Improve the model for everyone」をオフにできます。
Anthropicが商用製品として挙げているのは、Claude for WorkやAnthropic APIなどです。既定では入力と出力を学習に使わないと書かれています。消費者向けのClaude Free、Pro、Maxは別のページで扱われ、学習に使われる場合として3つが挙がっています。本人が学習への利用を許可することを選んだとき、会話が安全性レビューの対象として検出されたとき、試験プログラムに明示的に参加したときです。Incognitoチャットは、許可の設定が有効でも学習に使われません。
Google Workspaceは、利用者のプロンプトは顧客データにあたると説明しています。顧客の事前の許可や指示なく学習へ使うことはない、としています。個人向けのGeminiは扱いが違います。アクティビティの保存をオンにしていると、一部の会話が人によるレビューの対象になります。その分は最長3年保持され、保存をオフにすれば学習には使われません。
Microsoft 365 Copilotのページが挙げているのは、プロンプト、応答、Microsoft Graph経由で参照されるデータです。いずれも基盤モデルの学習には使われないと書かれています。個人向けCopilotの条件は今回確認できていないので、自社の契約プランのページで確認してください。
社内ルールには、サービス名だけでなくプラン名まで書いてください。「ChatGPTは可」と書くのではなく、「ChatGPT Businessの会社アカウントのみ可、個人アカウントは不可」と書きます。あわせて、確認した日付も残してください。各社の規約と設定画面は頻繁に変わります。
冒頭に挙げた19.9%は、この設定と契約の話です。白書の設問は「生成AIへの入力データを学習データとして利用できない仕組みを導入している」でした。就業者に自社の状況を尋ねた結果が19.9%です。大企業に勤める就業者で19.8%、中小企業に勤める就業者で20.3%と、ほぼ差がありません。紙のルールと設定の開きは、少なくとも規模では説明できません。
出力の確認手順
出力は必ず人が確認する、と書いてください。IPAのコラムの3番目と4番目がこれにあたります。AI事業者ガイドラインの第5部にも、出力について精度とリスクの程度を理解したうえで利用することが挙がっています。
ただ「確認する」だけでは運用されません。何を見るかと、誰が見るかを分けて書いてください。見る対象はこの3つです。
- 事実と数値が正しいか。統計や法令の数字は、一次資料に当たって裏を取る
- 出典が実在するか。生成AIは実在しないURLや書名を出すことがある
- 既存の文章に似すぎていないか。社外に出す文章は特に注意する
誰が見るかは、公的資料が具体的な様式まで示していない部分です。一案として2段階に分ける形があります。作業者本人が事実と出典を確認し、社外に出す文書だけ、作業者以外の1名が公開前に見る形です。全部を二重確認にすると回らなくなるので、社外に出るものに絞るのが現実的です。
権利のチェック
権利のチェックは、入力側と出力側で必要性が違います。JDLAのひな形は、ロゴやデザインを生成AIに入力する際には登録商標・意匠の調査の必要性は乏しいが、生成物を利用する場合には調査が必要だと整理しています。
社内ルールに書くのは、商用利用の前に調べるという一点です。対象は、商品名、ロゴ、キャッチコピー、広告に使う画像です。
調べる場所はJ-PlatPat(特許情報プラットフォーム)です。独立行政法人工業所有権情報・研修館が運営していて、商標と意匠を無料で検索できます。会員登録もいりません。
無料でできるのは、同じ名称や似た図柄がすでに登録されていないかを確かめるところまでです。似たものが出てきたとき、指定商品・役務の区分が自社の事業と重なるかどうかの判断は、弁理士に回してください。この切れ目と、調べた結果の残し先も書いておきます。
相談窓口と記録の決め方
6つ目の「相談窓口と記録」は、担当者名か部署名を1行書くだけで機能します。白書の設問に「AIガバナンスの取組を推進する部署や責任者が明確になっている」があります。同じ調査で就業者に自社の状況を尋ねたところ、そう答えた割合は35.9%でした。ここが空欄だと、迷った社員は誰にも聞かずに自分で判断します。
残す記録は2種類で足ります。窓口に来た相談と対応の記録、そしてヒヤリハットの記録です。どちらも、次の見直しで何を直すかの材料になります。
窓口を機能させるコツは、報告した人を責めない運用を明記しておくことです。入力してはいけない情報を入れたと後から気づいた社員が、黙っていられる設計にしないでください。
公開されているひな形から自社版を作る手順
ゼロから書く必要はありません。公的機関や業界団体が無償で公開しているひな形(サンプル)として確認できたのは、JDLAの「生成AIの利用ガイドライン」です。公的機関と業界団体の範囲で探した限り、穴埋め式で配られているのはこれだけでした。検索上位に並ぶほかの文例は、ベンダーが自社サイトで公開しているものです。
JDLAの資料室の「生成AIの利用ガイドライン」の欄から、氏名やメールアドレスの登録なしでダウンロードできます。形式はWord(.docx)なので、【】の部分をそのまま書き換えられます。条項だけの版と簡易解説付きの版があり、初めて作るなら解説付きを選んでください。
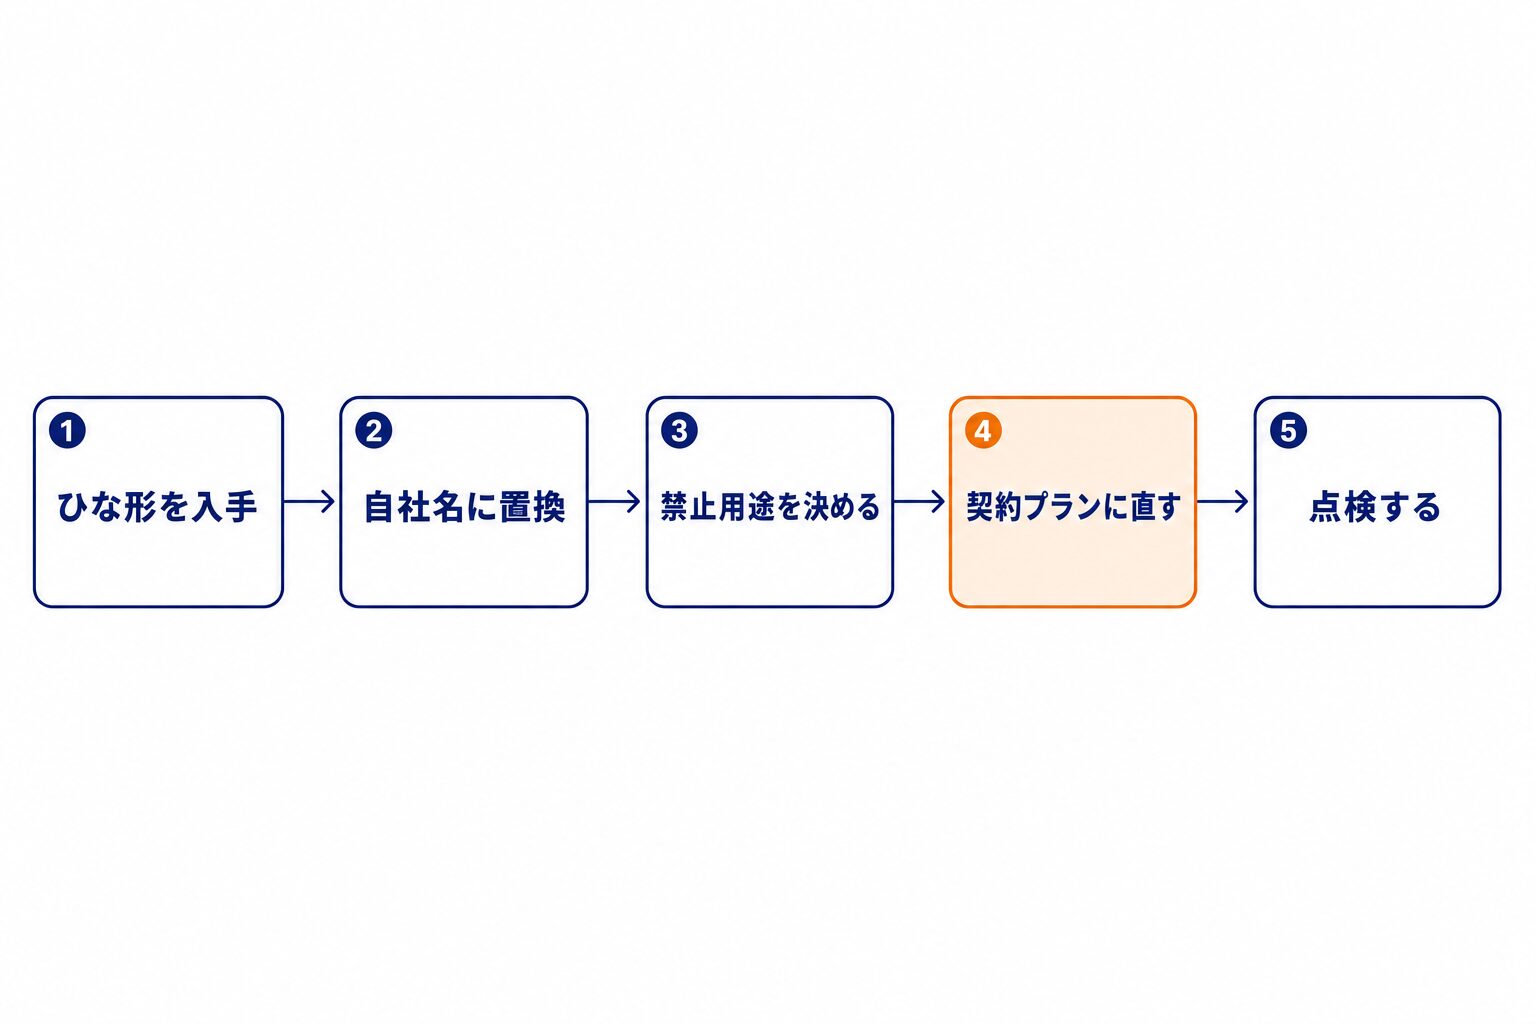
自社版に直す5つの段取り
作業は次の順で進みます。目安は、合意形成にかかる分を含まない、手を動かす時間です。
| 段取り | 誰がやるか | 目安 |
|---|---|---|
| 1 資料室からひな形をダウンロードする | 起案者 | その場で |
| 2 本文中の【】を、自社の名称と使ってよいサービス名に置き換える | 起案者 | 半日程度 |
| 3 禁止する用途を決めて、空欄の第3章を埋める | 起案者と、実際に使っている社員数名 | 打ち合わせ1回 |
| 4 第5章のデータ入力の記述を、自社が契約しているプランの内容に直す | 起案者と、契約を管理している担当 | 半日程度 |
| 5 AI事業者ガイドラインの別添7チェックリスト1枚目で点検する | 起案者 | 1時間程度 |
草案は、実際に生成AIを使っている社員に書いてもらってください。使っていない人が書くと、現場が守れない条文が混ざります。
決裁が要るのは最後の1回だけです。1から5を終えた草案を決裁権のある役員に諮り、承認後の配布と説明は総務か情報システムの担当が担います。上長に着手を申請するときは、この表と本記事の公的資料のURLを添えれば足ります。新しい予算も外部発注も出ない作業です。
このひな形の章立ては、1が目的、2が対象とする生成AI、3が禁止される用途、4が構成、5がデータ入力の注意、6が生成物利用の注意です。手を入れるのは3と5で、ほかはそのまま使えます。
第5章は、注意が必要なデータを6つの類型に分けています。
- 第三者が著作権を有しているデータ
- 登録商標・意匠
- 著名人の顔写真や氏名
- 個人情報
- 他社から秘密保持契約(NDA)で開示された秘密情報
- 自組織の機密情報
第6章が扱うのは、生成物を使うときの5つのリスクです。虚偽が含まれる可能性、既存の権利を侵害する可能性、生成物に著作権が発生しない可能性、商用利用できない可能性、サービスのポリシー上の制限です。
禁止用途を書くときは、2つを区別してください。生成AIを使うこと自体を禁止するのか、生成AIだけで作った成果物を禁止するのか、です。ひな形の解説も、どちらなのかを明示するとよいと述べています。
業務に置き換えると、こう書けます。営業資料やメール文面の初稿は生成AIで作ってよい。一方で、契約書のドラフト、人事評価の文面、顧客への最終回答は、生成AIだけで作ったものを提出してはならない。禁止するのは提出であって、下書きに使うことまで止める必要はありません。
2023年10月版のまま残っている箇所
このひな形は第1.1版(2023年10月公開)で、当時の前提が残っています。そのままコピーすると実態と食い違うのが、第5章(4)の個人情報の項です。書き出しは「【ChatGPT】においては入力したデータが【OpenAI社】のモデルの学習に利用されることになっていますので」。だから個人情報を入力しないでください、と続きます。
この記述は2023年10月時点の規約を前提にしています。法人プランで契約している場合は、ここを自社の契約内容に置き換えてください。プラン名と、そのプランでの学習の扱い、確認した日付の3つを書きます。
ひな形自身も、各組織の既存のデータポリシーと整合性を取るなど加筆修正して使うための雛型だと前文で述べています。無料版と有料版でどこが違うかは、ChatGPT PLUSの解説で整理しています。
別添7のチェックリストによる自己点検
書き上げたら、自己点検の道具があります。AI事業者ガイドラインの別添7 チェックリスト[全主体向け]は2ページで、1枚目に9項目が並んでいます。項目は「共通の指針」を要約したもので、すべて問いの形をとっています。たとえば「プライバシーを尊重・保護し、関係法令を遵守しているか?」「AIガバナンスやプライバシーに関するポリシー等を策定しているか?」といった具合です。中小企業でもそのまま使えます。
ただし、このPDFの2枚目は広島AIプロセスの12項目で、高度なAIシステムの開発者向けです。生成AIを使うだけの会社には関係しないので、1枚目だけを使ってください。項目ごとに検討を深めたい場合は、同じ別添7のワークシートがExcel形式で公開されています。
2026年のルールに足したい3項目
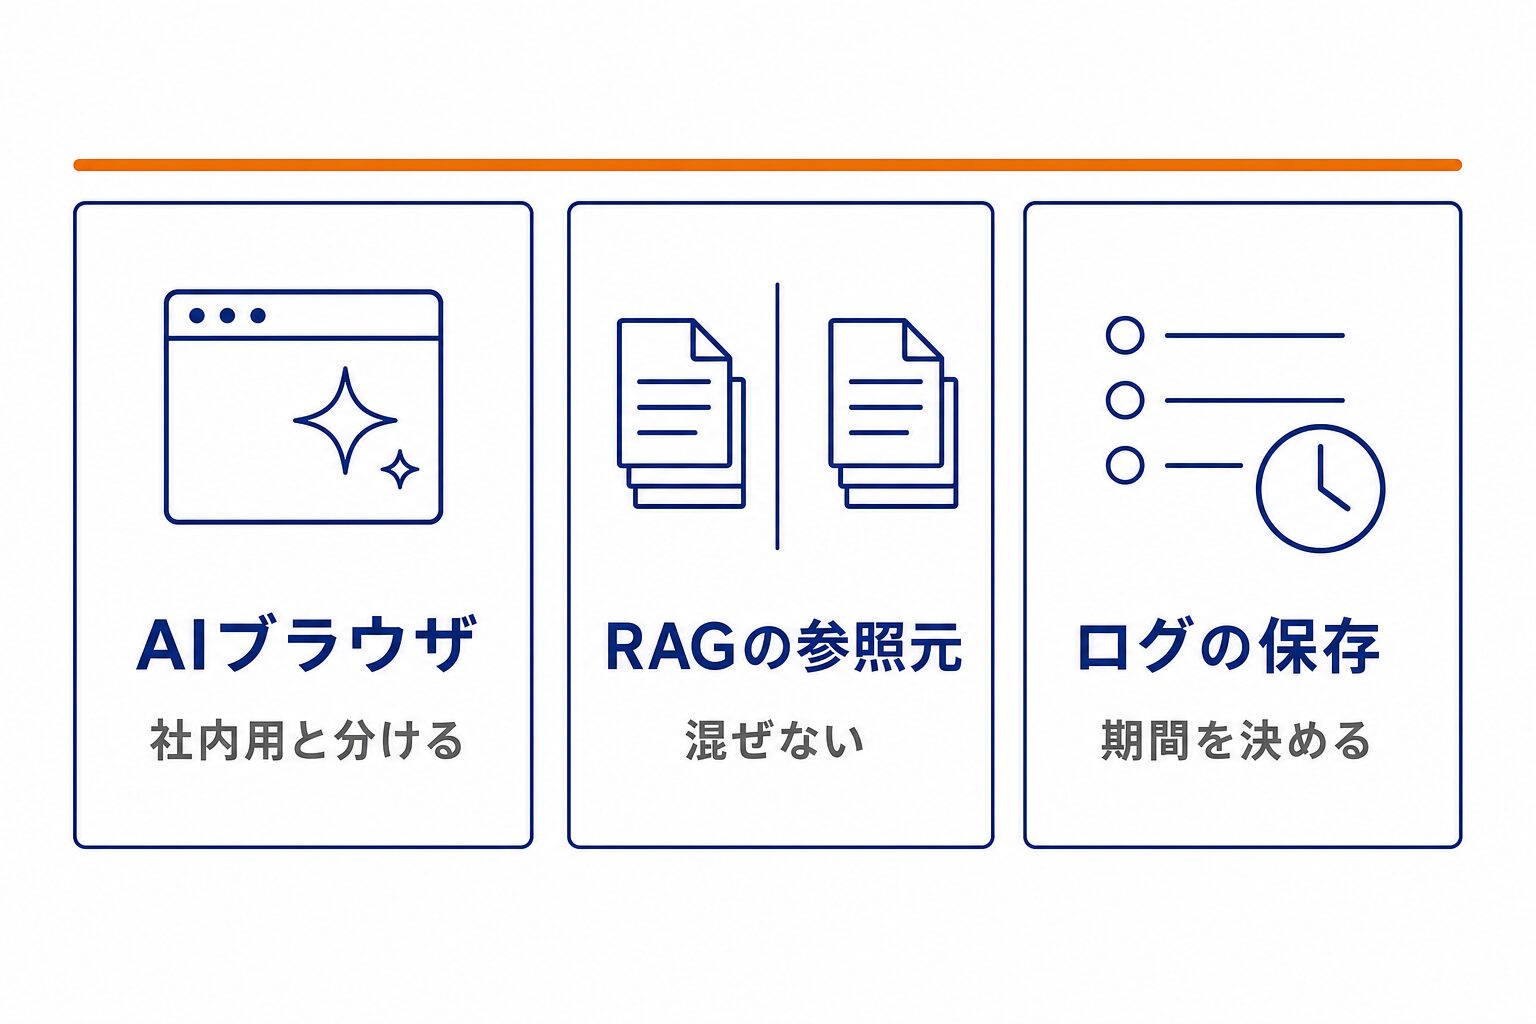
2023年から2024年にかけて作られた社内ルールには、載っていない項目があります。AIブラウザ、RAG、ログの3つです。
AIブラウザは、開いているページの内容をAIが読み取って、操作まで代行するブラウザです。RAG(検索拡張生成)は、社内文書などを検索してAIの回答に反映させる仕組みです。ログは、誰がいつ何を入力し、何が出力されたかの記録です。
IPAは2026年4月2日にAI利用者のためのセキュリティ豆知識を公開しました。5つの見出しのうち3つが、いま足すべき項目に直結します。「クラウドAIに営業秘密は教えない」「AIブラウザは社内用と社外用を分ける」「RAG使用時は『混ぜるな危険』にご用心」です。残る2つは「外見では詐欺師を見破れないと心得る」「AI仕込みのサイバー攻撃も撃退法は従来通り」でした。
同じIPAの情報セキュリティ10大脅威 2026では、組織向けの第3位に「AIの利用をめぐるサイバーリスク」が初めて選出されました。1位はランサム攻撃、2位はサプライチェーンや委託先を狙った攻撃です。
AIブラウザの分離
社内システムにログインした状態でAIブラウザを使うと、画面上の情報がそのままAIの入力になります。
IPAが挙げているのは、社内用と社外用を分ける運用です。社内システムを開くブラウザと、AIブラウザを別々にしておけば、誤って混ざることを構造的に防げます。
社内ルールには「AI機能付きブラウザの業務利用は窓口に相談」と1行書いておけば十分です。製品名を挙げると、次の製品が出たときに書き直しになります。
RAGで参照するデータの管理
社内のマニュアルやFAQを読ませる使い方が広がっています。AI事業者ガイドラインの別添にも、脚注でこの注意が入っています。RAGの活用など外部のサービスやデータと連携する場合は「意図しない範囲に重要情報(個人情報・機密情報等)が漏洩してしまうこと等に特に注意が必要となる」という指摘です。別の脚注では、検索・参照するデータの不正な変更や操作を早期に検出するため、定期的な管理・監査の実施が挙げられています。
社内ルールで決めるのは1点です。RAGに読ませてよい文書の置き場所を指定し、そこに何を置くかを決める人を明記してください。閲覧権限が異なる文書を1つの置き場所に混ぜると、権限の低い人が回答経由で読めてしまいます。
置き場所と管理者を決めずに入れると、中身を誰も保証できない検索箱になって使われなくなります。仕組みが現場で回らない理由はDXがうまくいかない理由と共通です。
ログの管理体制
ログは、事故が起きてから集めようとしても手遅れになります。別添5「AI利用者向け」は、具体的な手法としてログの管理を挙げています。「AIシステム・サービスの利用過程におけるログ(操作履歴、入力・出力の記録等)の管理体制の整備」という項目で、実施の時期は「利用前」とされています。
同じ別添は「利用中」の項目として、不要なデータや冗長なログの削除等によるデータ最小化も挙げています。取りっぱなしにしないことまで含まれています。
中小企業で現実的なのは、法人プランの管理画面で取れるログの範囲を確認し、保存期間を決めて書いておく水準です。個人アカウントの利用を許すと、この確認自体ができません。使ってよいサービスを会社が決める理由は、ここにもあります。
本記事は一般的な情報提供であり、法的助言ではありません。ここで挙げた6項目は出発点です。規制業種(医療・金融・士業)、大量の個人データを扱う事業、EU域内への提供がある場合は追加の検討が要ります。個別の判断は弁護士等の専門家にご相談ください。
まとめ:A4一枚に書く文例
生成AIの社内ルールは、A4で1枚から始められます。以下は、本文の6項目に禁止用途と2026年に足す3点を加えて、条文の形にしたものです。【】を自社の名称と日付に置き換えれば、そのまま社内に配れます。
生成AI利用ガイドライン
制定日 【2026年◯月◯日】
適用範囲 当【社】の業務に従事するすべての者に適用します。正社員、契約社員、パート・アルバイトのほか、業務委託と派遣で当【社】の業務に従事する者を含みます。
第1条 使ってよいサービス
当【社】が業務で利用してよい生成AIは、【ChatGPT Business】の会社アカウントのみとします。個人アカウントでの業務利用と、この一覧にないサービスの業務利用は認めません。使いたいサービスがある場合は、第9条の窓口に申請してください。
第2条 入力してよい情報
入力してよいのは、公開情報と架空データです。個人情報、他社から秘密保持契約(NDA)で開示された情報、当【社】の機密情報は入力しません。判断に迷う情報は入力せず、窓口に相談してください。
第3条 生成AIだけで仕上げてはならない文書
営業資料やメール文面の初稿を生成AIで作ることは認めます。一方で、契約書のドラフト、人事評価の文面、顧客への最終回答については、生成AIだけで作ったものを提出してはなりません。担当者が内容を確認し、必要な修正を加えたうえで提出してください。禁止しているのは提出であって、下書きに使うことではありません。
第4条 データの扱いの確認
【ChatGPT Business】は、提供事業者が公開している資料で、既定では入力も出力も学習に使わないことを確認しています(【2026年9月14日】確認)。プランを変更したときと年1回、【総務部】が同じ確認を行い、この記述を更新します。
第5条 出力の確認手順
生成物は必ず担当者が確認します。事実と数値は一次資料に当たって裏を取り、引用した出典のURLを保存します。社外に出す文書は、担当者以外の1名が公開前に確認します。
第6条 権利のチェック
商品名、ロゴ、キャッチコピー、広告に使う画像など、商用利用する生成物は、使用前にJ-PlatPatで登録商標と登録意匠を調べます。調査は【総務部】が行い、結果を記録に残します。似た登録が見つかった場合は、使用の可否を弁理士に確認します。
第7条 AI機能付きブラウザ
ページの内容を読み取って操作を代行するAI機能付きブラウザは、社内システムにログインする端末では使用しません。業務で使いたい場合は、窓口に相談してください。
第8条 RAGに読ませる文書
社内文書を生成AIに検索させる場合、読ませてよい文書は【共有サーバーの◯◯フォルダ】に限ります。このフォルダに何を置くかは【総務部】が決め、閲覧権限が異なる文書を混在させません。
第9条 ログと相談窓口
【総務部】は、利用の開始前に、管理画面で取得できるログの範囲と保存期間を確認し、記録します。本ガイドラインに関する相談窓口は【総務部・○○】です。入力してはいけない情報を入れてしまった場合も、気づいた時点で窓口に共有してください。窓口は相談内容と対応を記録します。
次回の見直し 【2027年◯月】。契約プランの変更、使ってよいサービスの追加、関係法令の改正があった場合は、この時期を待たずに見直します。
違反が判明した場合の扱い 気づいた時点で自ら窓口に申し出た場合、申し出たこと自体を理由に不利益な扱いはしません。故意に機密情報を持ち出すなど、就業規則の懲戒事由に当たる行為は、就業規則にしたがって扱います。
ここまでの材料は、すべて無償で入手できます。ゼロから考える部分は、自社の固有名詞だけです。
見落としやすいのは、紙と設定のずれです。冒頭で見たとおり、ガイドラインを整備していると答えた割合に対して、学習に使わせない仕組みを入れていると答えた割合は半分以下でした。同じ調査で就業者が挙げた生成AIのリスクは、「社内情報の漏洩などのセキュリティリスクがある」の46.4%が最多です。いちばん心配されていることに、技術的な手当てが追いついていません。
もうひとつ、書いただけで終わる型もあります。配って読まれない文書は、無いのとほとんど同じです。ルールを配ったら、同じ内容を説明する場を1回は設けてください。社員向けの伝え方は生成AI研修の選び方で整理しています。
自社の状況に合わせて6項目をどう埋めるか、社内にどう展開するか。検討の材料として、生成AI研修と導入支援の内容をまとめた資料をご用意しています。資料請求からお受け取りください。